Image-to-Markup / im2latex · 2016–2017 年研究
从图像恢复
LaTeX 与 HTML
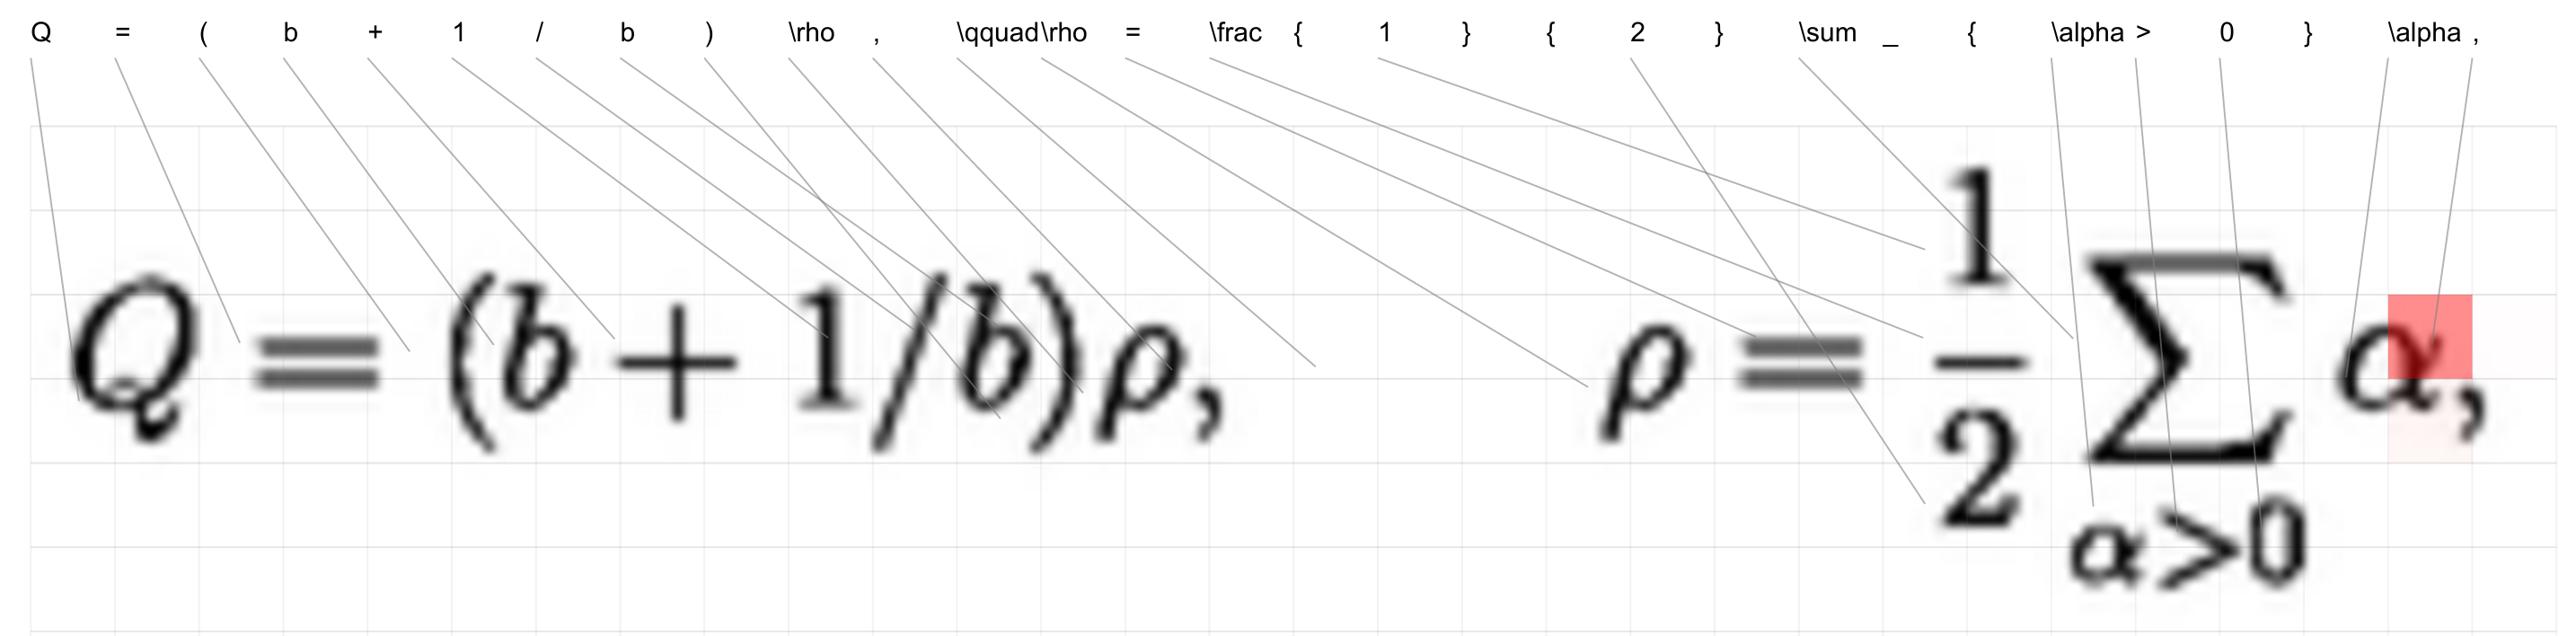
让神经网络从图像中恢复内容和布局,生成结构化标记。IM2LATEX-100K 为其中的数学公式识别任务提供公式图片与 LaTeX 源码配对数据。
原始研究 · 2016。 Yuntian Deng、Anssi Kanervisto 与 Alexander M. Rush 在 What You Get Is What You See: A Visual Markup Decompiler 中介绍 IM2LATEX-100K,并研究图像到 LaTeX 和 HTML。后续 ICML 2017 论文由 Yuntian Deng、Anssi Kanervisto、Jeffrey Ling 与 Alexander M. Rush 完成。
研究内容
恢复图像背后的结构
图片转 LaTeX 与数学公式识别
数学公式包含上下标、分式等二维结构。原始模型结合卷积图像编码器、行编码器与带注意力的循环解码器,根据公式图片逐步生成 LaTeX 标记。
模型从配对数据中学习图像到标记语言的映射;目标是生成能够重现输入公式图像的源码。阅读 2016 年原文。
由粗到细的注意力
ICML 2017 论文进一步研究图片转 LaTeX,先选择图像中的支持区域,再进行细粒度注意力计算,以降低视觉注意力的计算开销。
论文评估印刷公式识别,并通过单独的合成手写数据研究向手写公式识别的迁移。
图像到标记语言
从网页图像生成 HTML
2016 年的工作同时研究 LaTeX 和 HTML,展示同一种神经建模思路如何学习不同标记语言。
HTML 实验使用 100,000 个合成片段及其网页渲染图像,包含嵌套布局、相对位置和文字。模型从图像学习恢复 HTML,研究如何重建页面元素及其空间关系。具体数据生成方式与实验结果见原始论文;代码仓库保留合成 HTML 示例。
公式识别数据集
IM2LATEX-100K
公式来自 Cornell KDD Cup 收录的 arXiv 科学论文 LaTeX 源码,经渲染后与源码组成图像—公式对,用于训练和评估数学公式识别模型。
下载前请核对原始归档、项目托管原始与处理文件及 Hugging Face 导出的数据划分和预处理。
论文与数据记录
原始来源与发表时间
原始数据归档
IM2LATEX-100K Zenodo 归档由合作者 Anssi Kanervisto 制作并上传。此处日期为归档记录显示的发布日期。
代码与演示
原始实现
Harvard NLP 代码仓库提供 Torch 模型、预处理与评估脚本、预训练模型链接以及合成 HTML 示例。查看预处理、训练与评估命令。
查看模型输出与注意力
原始演示(英文)展示公式预测、注意力、模型结构和定性结果。
论文与引用
引用原始研究,注明数据版本
使用 IM2LATEX-100K、处理版本或 Image-to-Markup 模型时,请引用 ICML 2017 论文,并注明实际使用的数据版本和预处理。使用镜像或衍生版本时,同时保留原始数据集与新增工作的贡献说明。
ICML 2017 论文
Yuntian Deng, Anssi Kanervisto, Jeffrey Ling, Alexander M. Rush. Image-to-Markup Generation with Coarse-to-Fine Attention. ICML 2017,PMLR 70:980–989。
@inproceedings{pmlr-v70-deng17a,
  title = {Image-to-Markup Generation with Coarse-to-Fine Attention},
  author = {Deng, Yuntian and Kanervisto, Anssi and Ling, Jeffrey and Rush, Alexander M.},
  booktitle = {Proceedings of the 34th International Conference on Machine Learning},
  pages = {980--989},
  year = {2017},
  volume = {70},
  series = {Proceedings of Machine Learning Research},
  publisher = {PMLR},
  url = {https://proceedings.mlr.press/v70/deng17a.html}
}
2016 年原始论文
Yuntian Deng, Anssi Kanervisto, Alexander M. Rush. What You Get Is What You See: A Visual Markup Decompiler. 2016 年 9 月 16 日,arXiv:1609.04938v1。该版本介绍 IM2LATEX-100K,并研究公式图像转 LaTeX 与网页图像转 HTML。讨论原始研究和图像转 HTML 时,请引用这一版本。
@article{deng2016visualmarkup,
  title = {What You Get Is What You See: A Visual Markup Decompiler},
  author = {Deng, Yuntian and Kanervisto, Anssi and Rush, Alexander M.},
  journal = {arXiv preprint arXiv:1609.04938v1},
  year = {2016},
  url = {https://arxiv.org/abs/1609.04938v1}
}
使用原始归档时,还应注明 Anssi Kanervisto 发布的 IM2LATEX-100K 数据归档,DOI 10.5281/zenodo.56198。数据归档与研究论文分别记录数据发布和研究贡献。